用户档案(Enrich)
了解候选人基础信息、看机会指数、L1–L4 职级、近期动态和千人千面的分析,结合来源核验档案。
Enrich 是 DINQ 的候选人档案补全与分析功能。 它把分散的公开经历、作品、研究、职业信号和近期动态整理成一份便于评估与联系的档案,并结合本次搜索上下文给出匹配说明和招募建议。
这里的“用户档案”指你正在研究的候选人档案,不是你自己创建并公开发布的 Profile 个人主页。它也不同于 人才分析 中的单平台分析流程。
阅读 Enrich 时,可以按下面五类信息理解候选人:
| 分析 | 帮助理解什么 | 不等于什么 |
|---|---|---|
| 基础信息 | 这个人是谁,在哪里工作,有哪些可核验的经历和公开链接 | 完整背景调查或本人已确认的最新履历 |
| 看机会指数 | 从公开信号判断对新工作机会的可能开放程度 | 本人求职声明、回复率或接受 Offer 的概率 |
| L1–L4 职级 | 以统一的相对分层理解资历和可能承担的工作范围 | 候选人在某家公司的真实职级或薪酬等级 |
| 千人千面的动态分析 | 根据人才类型、搜索上下文和可用证据调整分析重点 | 给所有人套用同一份指标模板,或保证全天实时更新 |
| 近期动态 | 最近有哪些有公开来源的作品、活动或职业变化 | 完整行踪、全部活动记录或实时监控 |
在哪里生成和查看档案
- 在搜索结果的 档案 列点击 生成档案。
- 等待生成;完成后点击 查看档案。
- 需要一次处理多人时,勾选候选人,在工具栏选择 生成档案。
- 查看匹配结果、职业信号、招募建议和来源;不要只看最终分数。
本页详细介绍搜索页的新版档案。候选名单和人才雷达目前仍使用不同的档案面板,并非所有入口都会展示相同字段。
单列与双列布局
Enrich 支持以单列或双列查看 同一个候选人的同一份档案。这是面板宽度带来的展示变化,不是两个人的对比,也不会因切换布局重新生成档案或新增生成费用。
- 单列: 面板较窄时,基础信息和分析模块沿一列上下排列,向下滚动继续查看。
- 双列: 面板足够宽时,左侧展示姓名、职位、机构、简介、匹配结果和教育经历等基础信息;右侧展示能力与成果、职业状态、看机会指数和招募建议等分析结果。近期动态与来源可继续在左侧下方查看。
- 切换方式: 桌面端点击档案面板右上角的 展开宽版 / 收起宽版 图标。实际列数仍取决于可用宽度;窄屏不会为了双列而挤压内容。
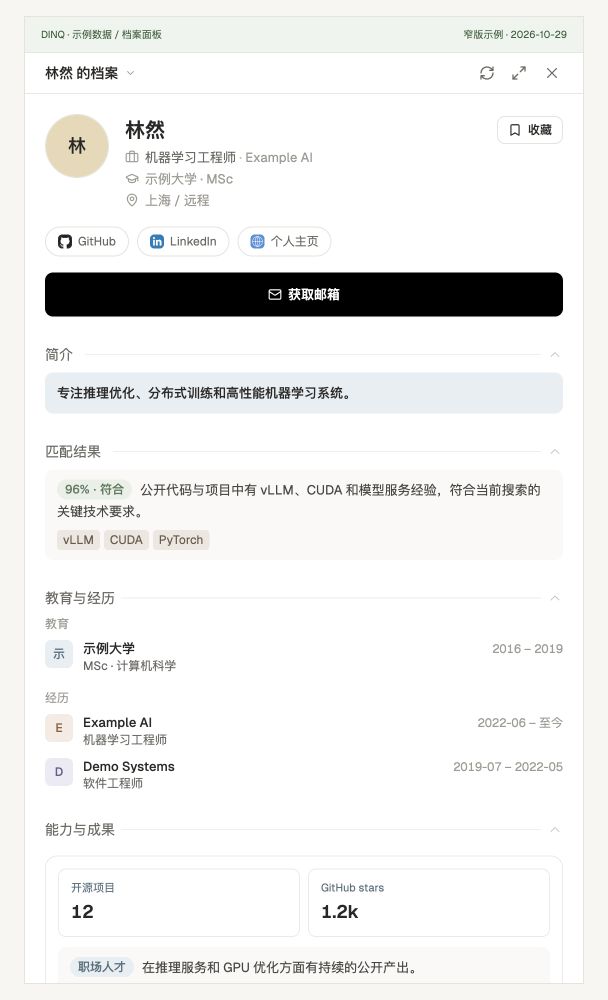
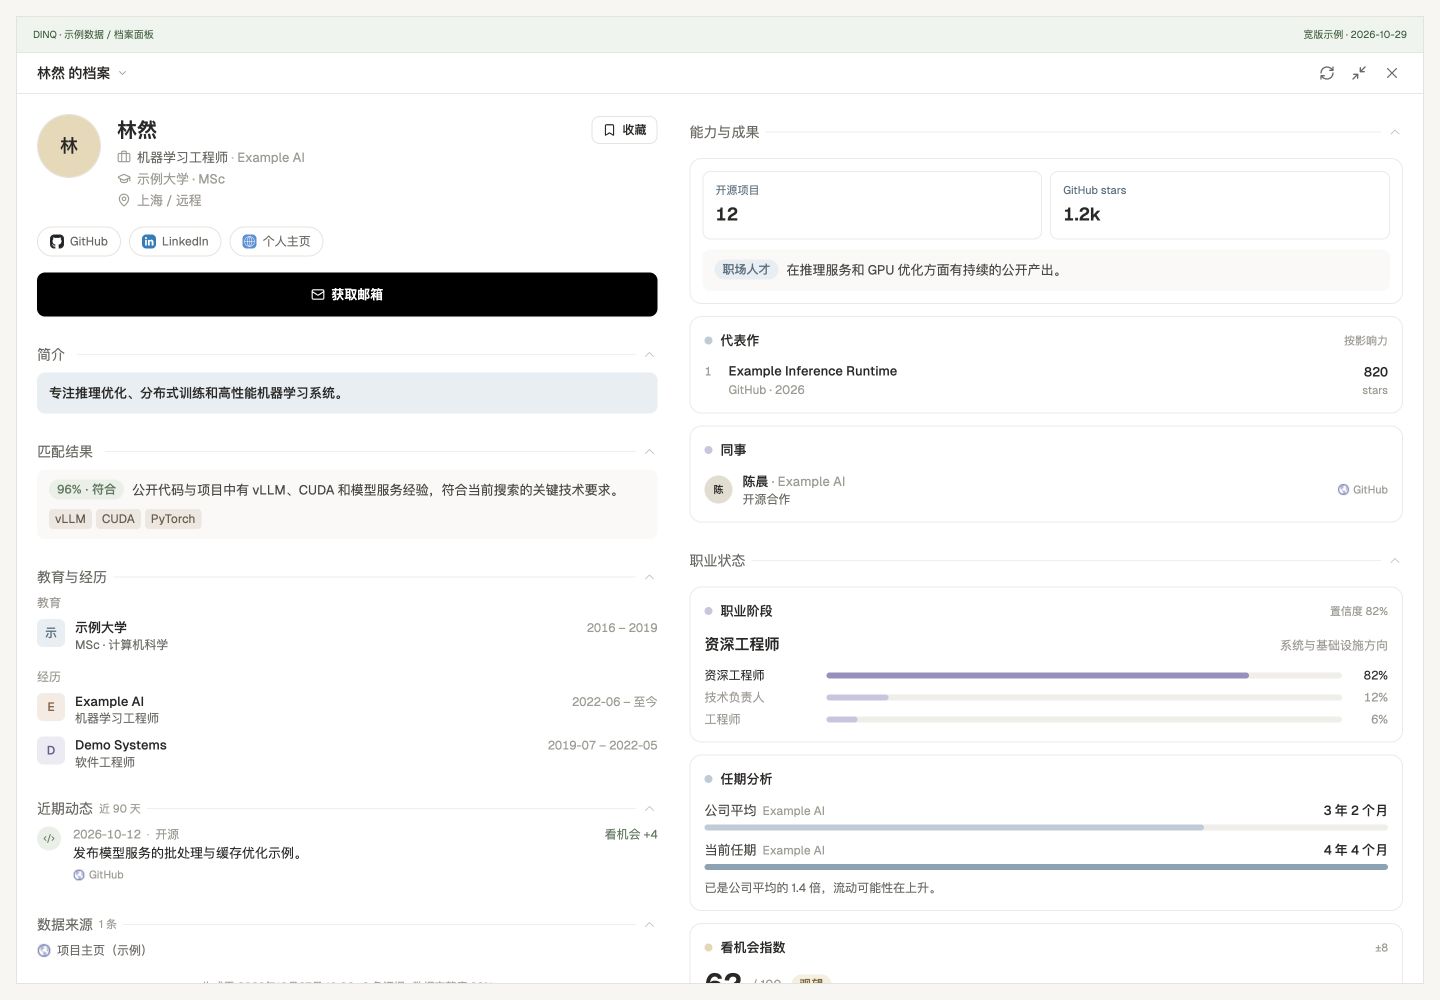
基础信息:先确认你看到的是谁
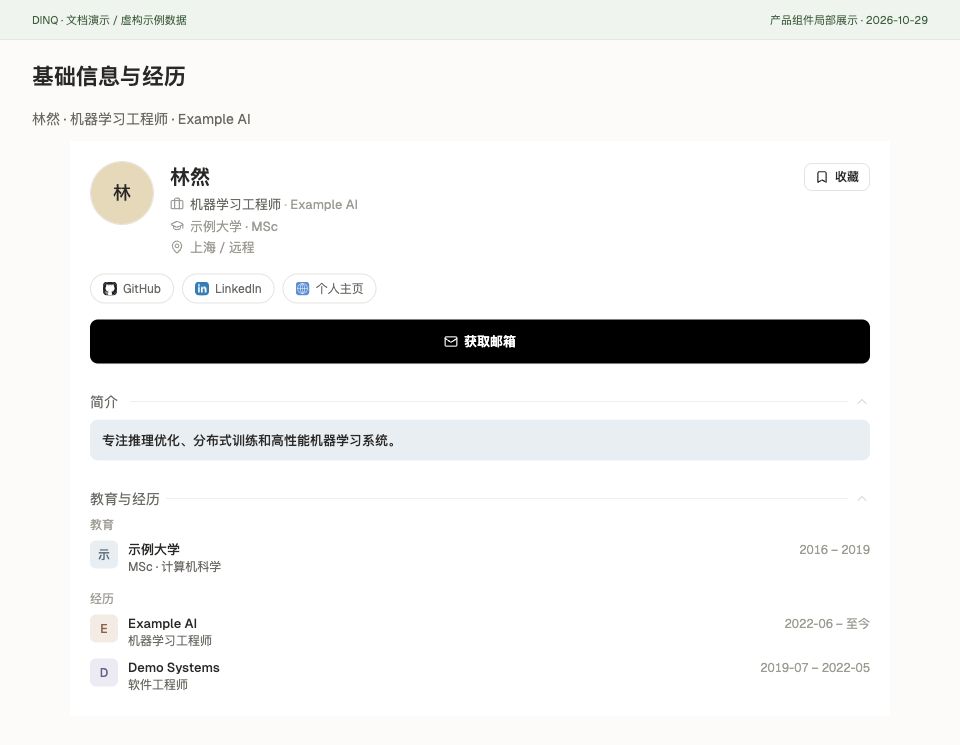
基础信息位于档案顶部,帮助你快速确认人物身份,再决定是否继续阅读分析。不同人物的公开信息完整度不同;没有找到的字段可能留空或使用中性占位。
| 信息 | 页面中的含义 | 建议怎样核对 |
|---|---|---|
| 头像与姓名 | 候选人的姓名、可用的中文名和头像;没有头像时可能展示姓名首字母 | 不要只凭照片或同名判断身份,结合机构、经历和公开主页确认 |
| 当前职位与机构 | 当前公开记录中的职位、公司、实验室或其他机构 | 查看原始职业资料或机构主页,留意是否已经变更 |
| 最高学历与地点 | 可用的学校、学位和公开地点信息 | 地点不等于求职地区偏好,学历缺失也不等于没有学历 |
| 一句话简介 | 对候选人方向、背景或代表性成果的简要概括 | 这是生成的摘要,需要结合下面的经历和作品阅读 |
| 公开平台链接 | GitHub、LinkedIn、Scholar、个人主页等可用链接 | 点击来源核对身份和具体产出;链接出现不代表本人已授权 DINQ 登录该账号 |
| 教育与工作经历 | 学校、机构、学位或职位及起止时间 | 检查时间线、重叠经历与当前任职是否一致;公开记录可能不完整 |
基础信息回答“这个人是谁”,匹配结果 回答“为什么可能适合当前需求”,两者不要混淆。同一个人可以有相同的经历,但在不同岗位需求下有不同的匹配说明。
看到 数据完整度 时,应把它理解为当前档案覆盖了多少类可用信息,而不是资料真实性、候选人能力或录用把握。档案末尾的 数据来源 和生成时间用于进一步核验;生成时间也不表示所有来源都是当天更新的。
顶部的 获取邮箱 是独立的联系方式查询入口,生成基础信息不会自动获得邮箱,也不会发送邮件。相关计费见下文,联系流程见 触达。
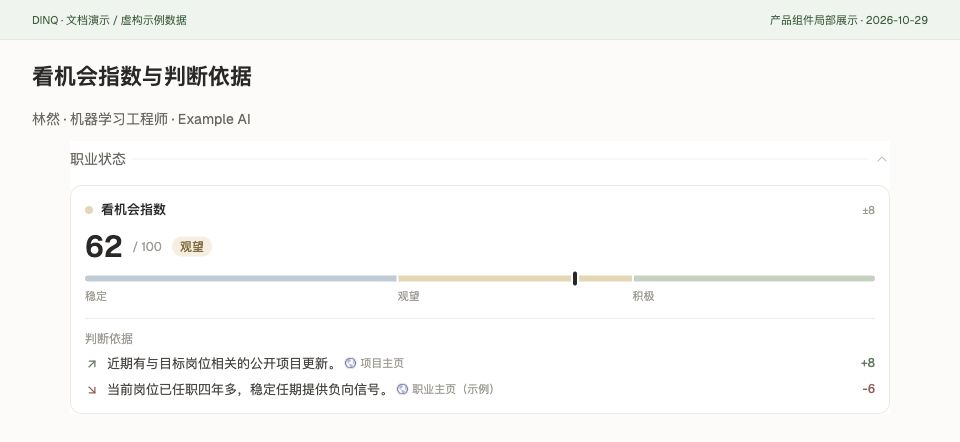
看机会指数
看机会指数是 0–100 的模型评估分数,用于辅助判断候选人对新工作机会的可能开放程度。 指数越高,模型认为越值得进一步了解其机会偏好;不代表对方已经在找工作。
| 分数 | 页面分档 | 如何理解 |
|---|---|---|
| 0–39 | 稳定 | 公开信号更偏向当前状态稳定,可以先建立联系、持续关注 |
| 40–69 | 观望 | 可能会考虑合适机会,适合带着具体岗位或合作背景进一步沟通 |
| 70–100 | 积极 | 模型认为开放程度较高,仍需直接确认意愿、时间与条件 |
阅读时要同时看 判断依据:职业阶段、当前任期、近期公开事件等可能提供正向或负向信号。依据旁的正负影响值帮助解释模型为什么这样判断,不是候选人的自我评分,也不要把它们直接相加当作最终分数公式。
页面展示的 ± 反映估计的不确定性,不是保证区间。80 分不是“80% 会跳槽”或“80% 会回复”;指数低也不表示拒绝一切联系。请核对来源和时间,再通过专业、尊重的沟通确认。
L1–L4 职级与资历分布
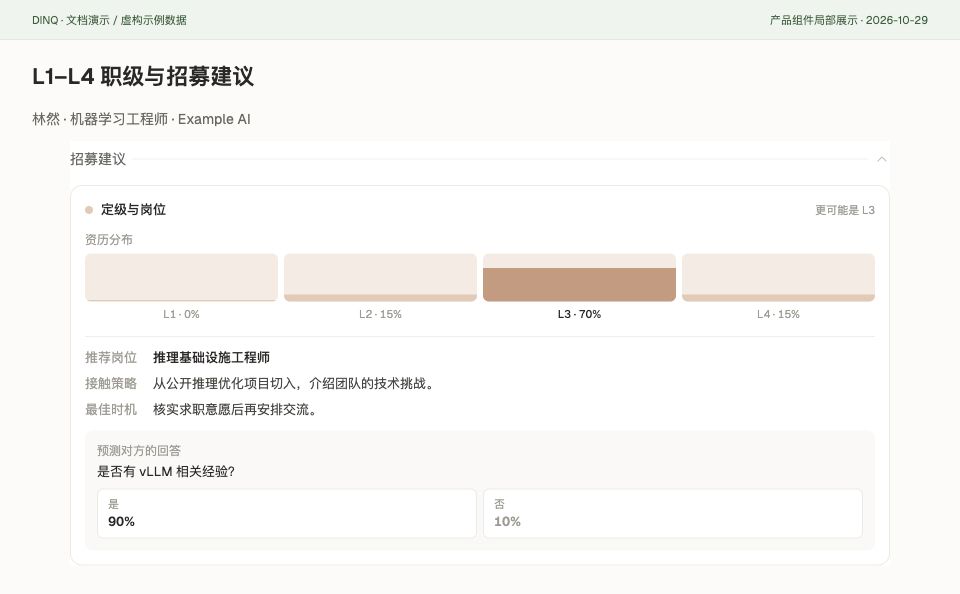
在 招募建议 > 定级与岗位 中,DINQ 用 L1–L4 表达候选人的相对资历层次,帮助跨不同公司、职位名称和人才背景理解其可能承担的职责。
| 档位 | 含义 | 参考工作范围 |
|---|---|---|
| L1 | 初级 / 应届 | 在指导和明确目标下完成具体任务 |
| L2 | 中级 | 独立负责一个模块、项目环节或研究课题 |
| L3 | 资深 / Staff | 定义方向、负责核心技术,或带领小团队 |
| L4 | 专家 / Principal | 在领域内具有广泛影响力,参与决定组织级方向 |
这是一套 DINQ 的相对资历分层,不是任何特定公司的内部级别,也不按工作年限机械换算。管理路线与专家路线都可能体现较高资历,不是只有管理人数多才能达到更高档位。
档案展示的是 L1–L4 的资历分布,而不只是一个绝对标签。例如,演示分布为 L3 60%、L4 30%、其他档位合计 10%,表示模型更倾向于 L3,同时保留其他可能;不是已经核实此人在现公司的职级。分布接近时尤其需要核对项目职责、影响范围和真实产出。
结合 推荐岗位、接触策略、最佳时机 阅读,会比单独比较 L 值更有用。职级分布不应直接用于确定薪酬、拒绝候选人或替代面试。
千人千面的动态分析
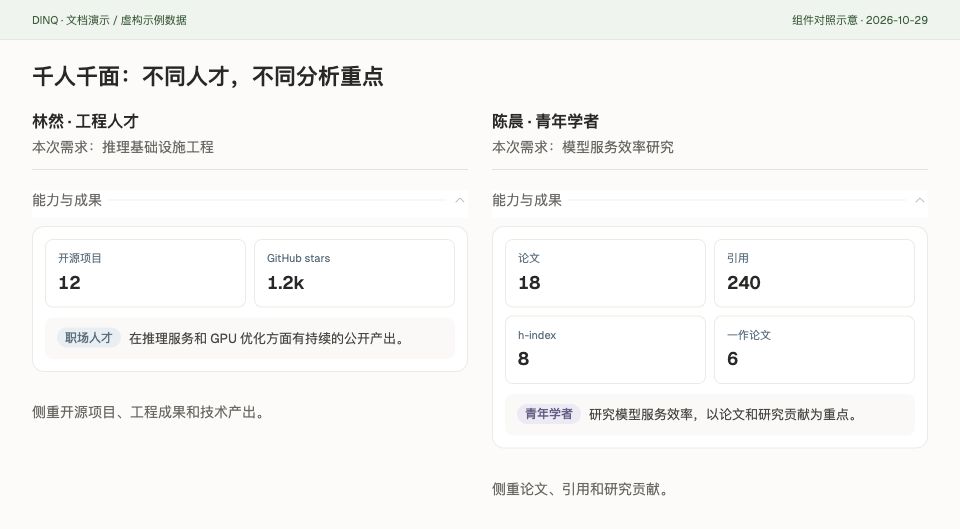
千人千面,是指分析重点会随候选人的人才类型、公开资料和本次搜索上下文变化。 DINQ 不会要求一名研究员、创作者和创业者都用同一组指标证明自己。
| 人才类型 | 可能重点展示的信号 |
|---|---|
| 职场人才 | 工作经历、职责与资历、任期、公开项目,以及同事或协作线索 |
| 创作者 / KOL | 内容、平台影响力和互动、代表内容,以及公开合作线索 |
| 创业者 | 公司与融资阶段、创业经历、代表产品和合作可能性 |
| 青年学者 | 研究方向、论文、引用、学术阶段,以及应届或实习资格线索 |
| 高校教职 | 学术成果、引用与合作网络,以及顾问或研究合作的相关线索 |
| 前沿实验室人才 | 论文与工程成果、实验室经历,以及可用的人才流动信息 |
| 公开资料主要来自 LinkedIn 的人才 | 优先展示可核验的职业经历与任期;缺少的作品或合作信息保留为空,不编造补齐 |
类型是组织分析的方式,不是对个人能力的高低排名。每一类实际显示哪些内容,仍取决于可用证据;公开信息少不等于能力弱。
搜索上下文也会影响匹配说明。 例如,同一候选人用于“大模型推理工程师”和“开发者生态负责人”两种不同需求时,应该核对的作品、相关经历和匹配理由并不一样。档案会使用本次请求携带的匹配上下文和身份线索来分析,而不是把一个分数永久贴在人身上。
这里的“动态”还包括一次生成中的分阶段补充与精修:更多来源到达后,匹配说明、判断依据和招募建议可能更新。它 不代表每次打开档案都会重新检索,也不代表全天自动追踪。相同请求可能复用缓存;需要持续发现人才时,可另看 人才雷达。
近期动态:了解最近发生了什么
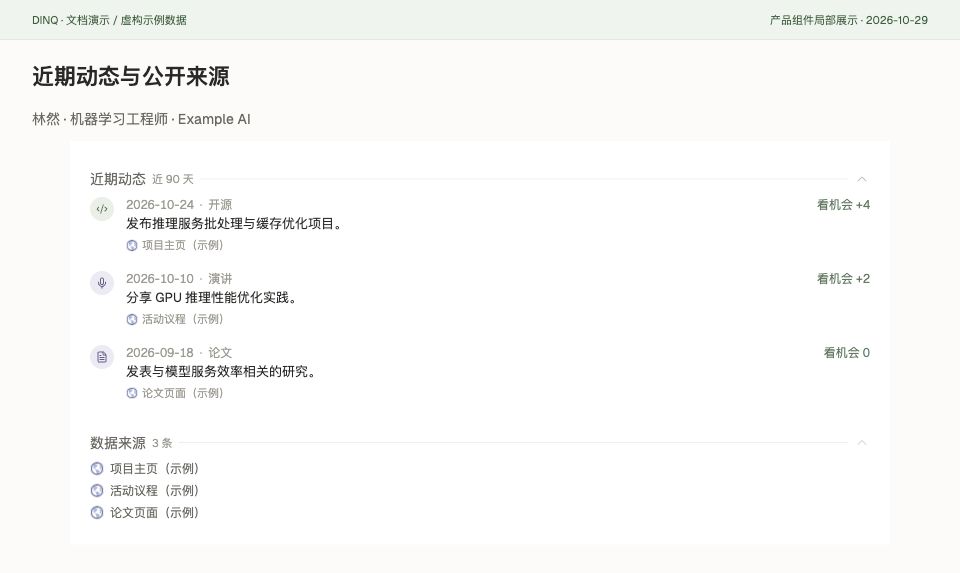
近期动态把可用的近 90 天公开事件整理为时间线,帮助你了解候选人最近在做什么,也为核验背景和准备有上下文的联系提供线索。常见类型包括论文、职位变动、开源、演讲、新闻、社媒、荣誉和内容发布。
每条动态按可用信息展示:
- 日期与事件类型: 帮助判断发生时间和活动性质,不要把旧报道当成刚发生的事件。
- 事件摘要: 用简短文字概括发生了什么,重要细节请回原始页面核验。
- 来源链接: 打开论文、项目、机构公告、新闻或公开帖子,确认事件是否属于同一个人。
- 对看机会指数的影响: 部分事件会显示正负影响值,用于解释模型判断;它不是本人对外表达的求职意愿,也不是该事件造成跳槽的证据。
例如,演示场景中一位候选人近期发布了推理优化项目,你可以打开仓库检查其实际贡献,再围绕相关工作准备沟通。单次演讲、发帖或职位变化本身,不足以证明对方正在求职。
近期动态与千人千面的动态分析不是同一件事。 前者整理“最近发生了哪些公开事件”,后者说明“为什么针对这个人、这次需求,采用这些指标和判断”。近期动态可以成为分析依据,但不是每个事件都会改变分数。
时间线取决于生成时能够获取的公开记录,并不是每次打开都重新抓取。使用缓存时,不要把它当作截至此刻的完整动态;没有显示记录也不代表候选人没有活动。持续发现人才可使用 人才雷达,重新生成规则见下文。
结合其他模块阅读
- 匹配结果: 对当前需求的分数、结论、理由和关键词。
- 教育与经历: 可用的学校、机构、岗位和起止时间。
- 核心指标与代表作: 按人才类型选择指标,并关联论文、代码、项目或内容作品。
- 合作者或同事: 有公开依据的关系线索,不代表对方愿意提供推荐。
- 职业阶段与任期: 与 L1–L4 分开阅读;在读阶段、任职年限和职责层次不是同一概念。
- 近期动态与来源: 可用的近 90 天公开事件、来源链接、生成时间和数据完整度。
看机会指数、岗位匹配分数、职业阶段置信度和 L1–L4 分布回答的是不同问题,不要把它们当成同一个评分,也不要用数据完整度代替能力判断。
生成、缓存与计费
搜索页新版档案每次成功生成扣除 5 Credits。同一用户在 7 天内,以相同姓名、匹配上下文、身份线索和语言请求,可复用已有档案而不再扣费。
主动 重新生成档案 会跳过缓存,成功后再次扣费;切换语言或改变请求上下文也可能需要新生成。生成中的补充与精修是该次生成流程的一部分,不要把每条进度提示理解为又开了一次新的收费生成。
获取邮箱是另外的操作,每位候选人成功获取邮箱 20 Credits,不包含在档案生成费用里。完整规则见 定价与 Credits。
如何使用分析结果
先看候选人是否适合当前需求,再结合职级分布理解工作范围,最后用看机会指数和公开依据准备接触方式。发送前可在 触达 中检查收件人和草稿。
所有预测都应与事实字段区分开。模型判断不是本人意愿、背景调查结论或录用决定;未找到信息也不等于不存在。重要判断请回到原始来源,并通过作品评审、面试和本人确认核验。