使用者檔案(Enrich)
瞭解候選人基礎資訊、看機會指數、L1–L4 職級、近期動態和千人千面的分析,結合來源核驗檔案。
Enrich 是 DINQ 的候選人檔案補全與分析功能。 它把分散的公開經歷、作品、研究、職業訊號和近期動態整理成一份便於評估與聯絡的檔案,並結合本次搜尋上下文給出匹配說明和招募建議。
這裡的“使用者檔案”指你正在研究的候選人檔案,不是你自己建立並公開發布的 Profile 個人主頁。它也不同於 人才分析 中的單平臺分析流程。
閱讀 Enrich 時,可以按下面五類資訊理解候選人:
| 分析 | 幫助理解什麼 | 不等於什麼 |
|---|---|---|
| 基礎資訊 | 這個人是誰,在哪裡工作,有哪些可核驗的經歷和公開連結 | 完整背景調查或本人已確認的最新履歷 |
| 看機會指數 | 從公開訊號判斷對新工作機會的可能開放程度 | 本人求職宣告、回覆率或接受 Offer 的機率 |
| L1–L4 職級 | 以統一的相對分層理解資歷和可能承擔的工作範圍 | 候選人在某家公司的真實職級或薪酬等級 |
| 千人千面的動態分析 | 根據人才型別、搜尋上下文和可用證據調整分析重點 | 給所有人套用同一份指標模板,或保證全天即時更新 |
| 近期動態 | 最近有哪些有公開來源的作品、活動或職業變化 | 完整行蹤、全部活動記錄或即時監控 |
在哪裡生成和檢視檔案
- 在搜尋結果的 檔案 列點選 產生檔案。
- 等待生成;完成後點選 檢視檔案。
- 需要一次處理多人時,勾選候選人,在工具欄選擇 產生檔案。
- 檢視匹配結果、職業訊號、招募建議和來源;不要只看最終分數。
本頁詳細介紹搜尋頁的新版檔案。候選名單和人才雷達目前仍使用不同的檔案面板,並非所有入口都會展示相同欄位。
單列與雙列布局
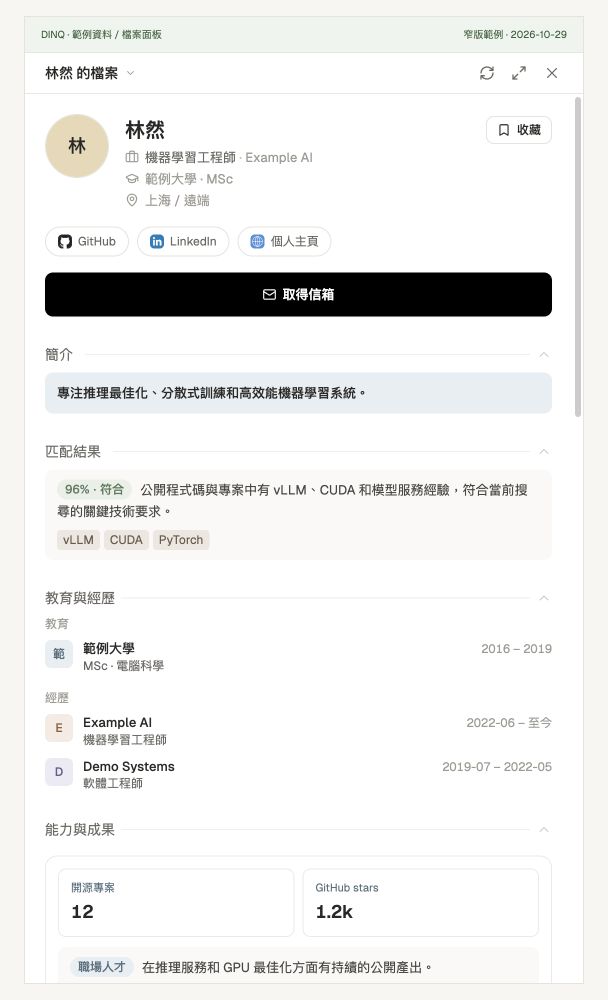
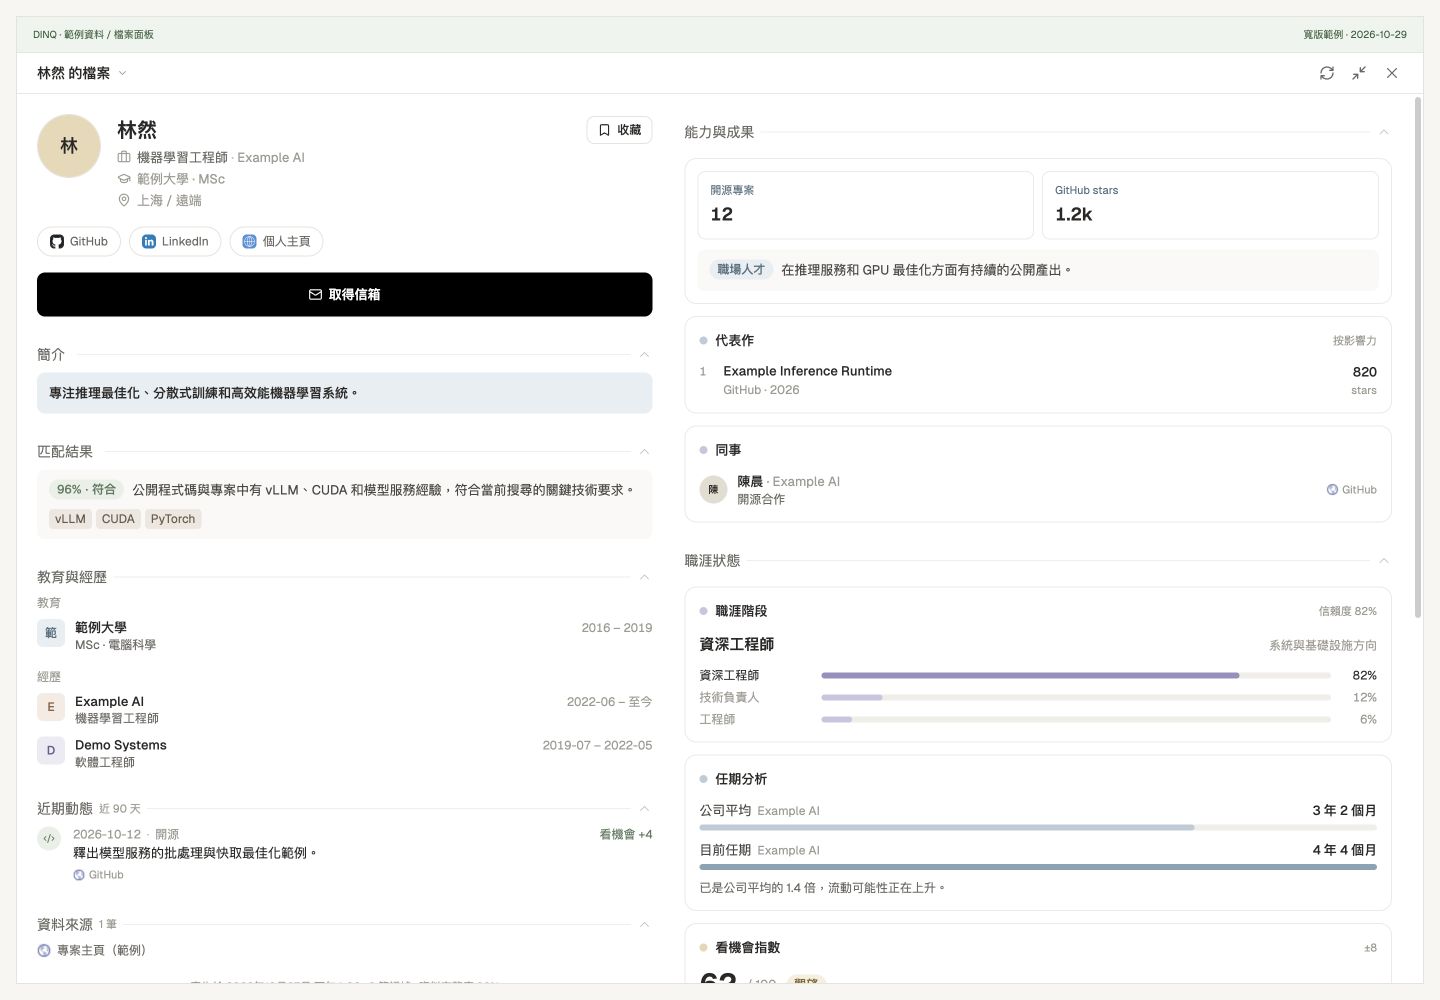
Enrich 支援以單列或雙列檢視 同一個候選人的同一份檔案。這是面板寬度帶來的展示變化,不是兩個人的對比,也不會因切換佈局重新產生檔案或新增生成費用。
- 單列: 面板較窄時,基礎資訊和分析模組沿一列上下排列,向下滾動繼續檢視。
- 雙列: 面板足夠寬時,左側展示姓名、職位、機構、簡介、匹配結果和教育經歷等基礎資訊;右側展示能力與成果、職業狀態、看機會指數和招募建議等分析結果。近期動態與來源可繼續在左側下方檢視。
- 切換方式: 桌面端點選檔案面板右上角的 展開寬版 / 收起寬版 圖示。實際列數仍取決於可用寬度;窄屏不會為了雙列而擠壓內容。
基礎資訊:先確認你看到的是誰
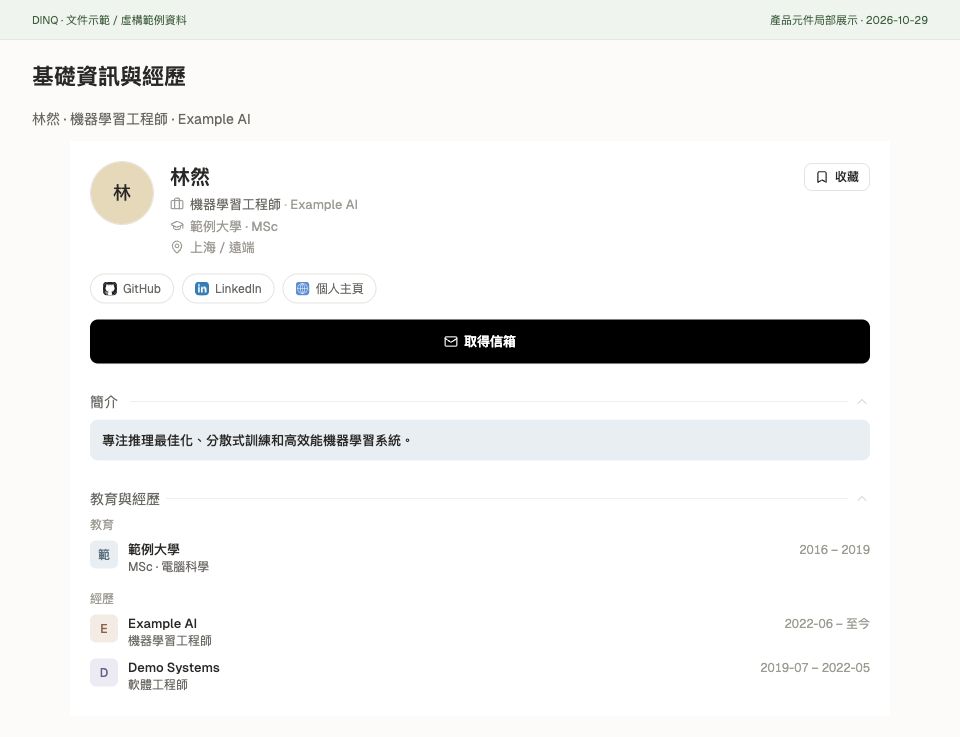
基礎資訊位於檔案頂部,幫助你快速確認人物身份,再決定是否繼續閱讀分析。不同人物的公開資訊完整度不同;沒有找到的欄位可能留空或使用中性佔位。
| 資訊 | 頁面中的含義 | 建議怎樣核對 |
|---|---|---|
| 頭像與姓名 | 候選人的姓名、可用的中文名和頭像;沒有頭像時可能展示姓名首字母 | 不要只憑照片或同名判斷身份,結合機構、經歷和公開主頁確認 |
| 當前職位與機構 | 當前公開記錄中的職位、公司、實驗室或其他機構 | 檢視原始職業資料或機構主頁,留意是否已經變更 |
| 最高學歷與地點 | 可用的學校、學位和公開地點資訊 | 地點不等於求職地區偏好,學歷缺失也不等於沒有學歷 |
| 一句話簡介 | 對候選人方向、背景或代表性成果的簡要概括 | 這是生成的摘要,需要結合下面的經歷和作品閱讀 |
| 公開平臺連結 | GitHub、LinkedIn、Scholar、個人主頁等可用連結 | 點選來源核對身份和具體產出;連結出現不代表本人已授權 DINQ 登入該帳號 |
| 教育與工作經歷 | 學校、機構、學位或職位及起止時間 | 檢查時間線、重疊經歷與當前任職是否一致;公開記錄可能不完整 |
基礎資訊回答“這個人是誰”,匹配結果 回答“為什麼可能適合當前需求”,兩者不要混淆。同一個人可以有相同的經歷,但在不同崗位需求下有不同的匹配說明。
看到 資料完整度 時,應把它理解為當前檔案覆蓋了多少類可用資訊,而不是資料真實性、候選人能力或錄用把握。檔案末尾的 資料來源 和生成時間用於進一步核驗;生成時間也不表示所有來源都是當天更新的。
頂部的 取得信箱 是獨立的聯絡方式查詢入口,生成基礎資訊不會自動獲得信箱,也不會發送郵件。相關計費見下文,聯絡流程見 觸達。
看機會指數
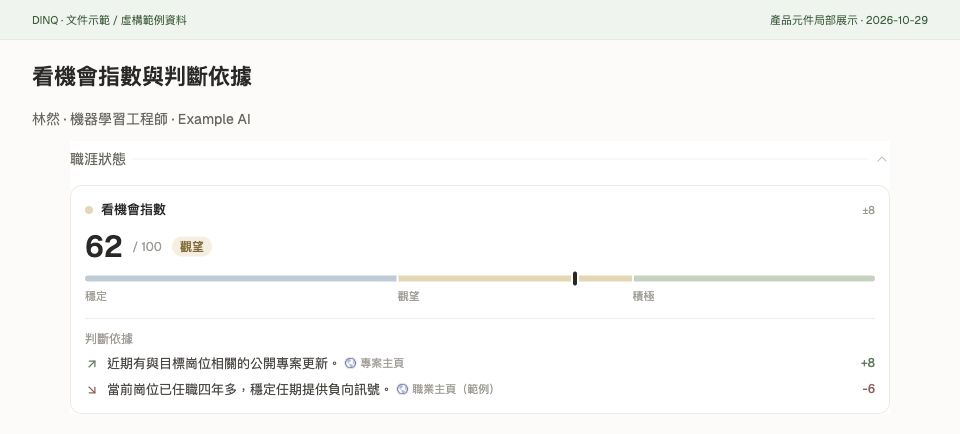
看機會指數是 0–100 的模型評估分數,用於輔助判斷候選人對新工作機會的可能開放程度。 指數越高,模型認為越值得進一步瞭解其機會偏好;不代表對方已經在找工作。
| 分數 | 頁面分檔 | 如何理解 |
|---|---|---|
| 0–39 | 穩定 | 公開訊號更偏向當前狀態穩定,可以先建立聯絡、持續關注 |
| 40–69 | 觀望 | 可能會考慮合適機會,適合帶著具體崗位或合作背景進一步溝通 |
| 70–100 | 積極 | 模型認為開放程度較高,仍需直接確認意願、時間與條件 |
閱讀時要同時看 判斷依據:職業階段、當前任期、近期公開事件等可能提供正向或負向訊號。依據旁的正負影響值幫助解釋模型為什麼這樣判斷,不是候選人的自我評分,也不要把它們直接相加當作最終分數公式。
頁面展示的 ± 反映估計的不確定性,不是保證區間。80 分不是“80% 會跳槽”或“80% 會回覆”;指數低也不表示拒絕一切聯絡。請核對來源和時間,再通過專業、尊重的溝通確認。
L1–L4 職級與資歷分佈
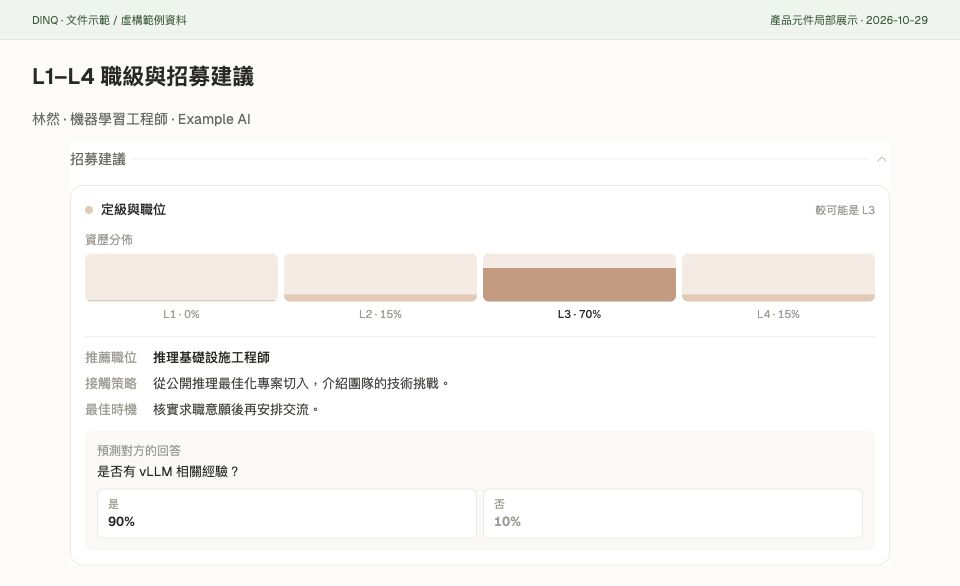
在 招募建議 > 定級與崗位 中,DINQ 用 L1–L4 表達候選人的相對資歷層次,幫助跨不同公司、職位名稱和人才背景理解其可能承擔的職責。
| 檔位 | 含義 | 參考工作範圍 |
|---|---|---|
| L1 | 初級 / 應屆 | 在指導和明確目標下完成具體任務 |
| L2 | 中級 | 獨立負責一個模組、專案環節或研究課題 |
| L3 | 資深 / Staff | 定義方向、負責核心技術,或帶領小團隊 |
| L4 | 專家 / Principal | 在領域內具有廣泛影響力,參與決定組織級方向 |
這是一套 DINQ 的相對資歷分層,不是任何特定公司的內部級別,也不按工作年限機械換算。管理路線與專家路線都可能體現較高資歷,不是隻有管理人數多才能達到更高檔位。
檔案展示的是 L1–L4 的資歷分佈,而不只是一個絕對標籤。例如,演示分佈為 L3 60%、L4 30%、其他檔位合計 10%,表示模型更傾向於 L3,同時保留其他可能;不是已經核實此人在現公司的職級。分佈接近時尤其需要核對專案職責、影響範圍和真實產出。
結合 推薦崗位、接觸策略、最佳時機 閱讀,會比單獨比較 L 值更有用。職級分佈不應直接用於確定薪酬、拒絕候選人或替代面試。
千人千面的動態分析
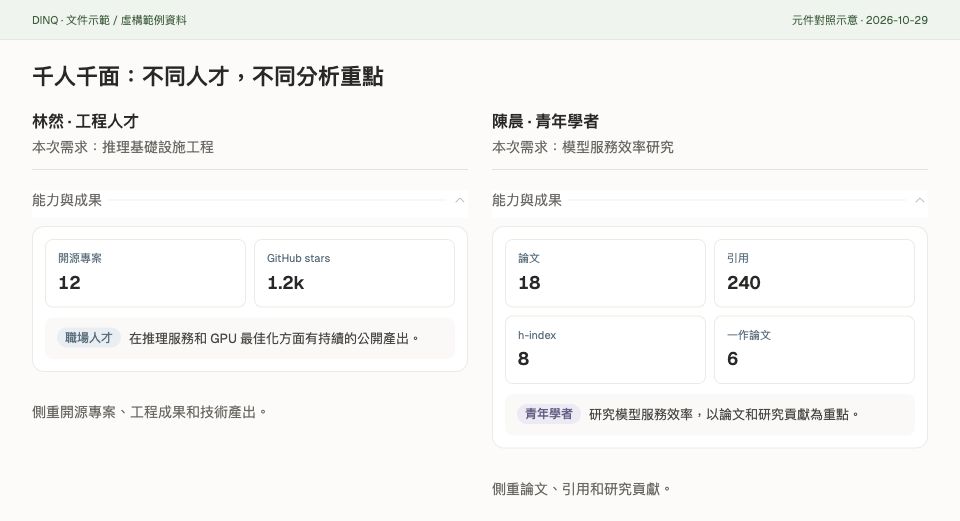
千人千面,是指分析重點會隨候選人的人才型別、公開資料和本次搜尋上下文變化。 DINQ 不會要求一名研究員、創作者和創業者都用同一組指標證明自己。
| 人才型別 | 可能重點展示的訊號 |
|---|---|
| 職場人才 | 工作經歷、職責與資歷、任期、公開專案,以及同事或協作線索 |
| 創作者 / KOL | 內容、平臺影響力和互動、代表內容,以及公開合作線索 |
| 創業者 | 公司與融資階段、創業經歷、代表產品和合作可能性 |
| 青年學者 | 研究方向、論文、引用、學術階段,以及應屆或實習資格線索 |
| 高校教職 | 學術成果、引用與合作網路,以及顧問或研究合作的相關線索 |
| 前沿實驗室人才 | 論文與工程成果、實驗室經歷,以及可用的人才流動資訊 |
| 公開資料主要來自 LinkedIn 的人才 | 優先展示可核驗的職業經歷與任期;缺少的作品或合作資訊保留為空,不編造補齊 |
型別是組織分析的方式,不是對個人能力的高低排名。每一類實際顯示哪些內容,仍取決於可用證據;公開資訊少不等於能力弱。
搜尋上下文也會影響匹配說明。 例如,同一候選人用於“大模型推理工程師”和“開發者生態負責人”兩種不同需求時,應該核對的作品、相關經歷和匹配理由並不一樣。檔案會使用本次請求攜帶的匹配上下文和身份線索來分析,而不是把一個分數永久貼在人身上。
這裡的“動態”還包括一次生成中的分階段補充與精修:更多來源到達後,匹配說明、判斷依據和招募建議可能更新。它 不代表每次開啟檔案都會重新檢索,也不代表全天自動追蹤。相同請求可能複用快取;需要持續發現人才時,可另看 人才雷達。
近期動態:瞭解最近發生了什麼
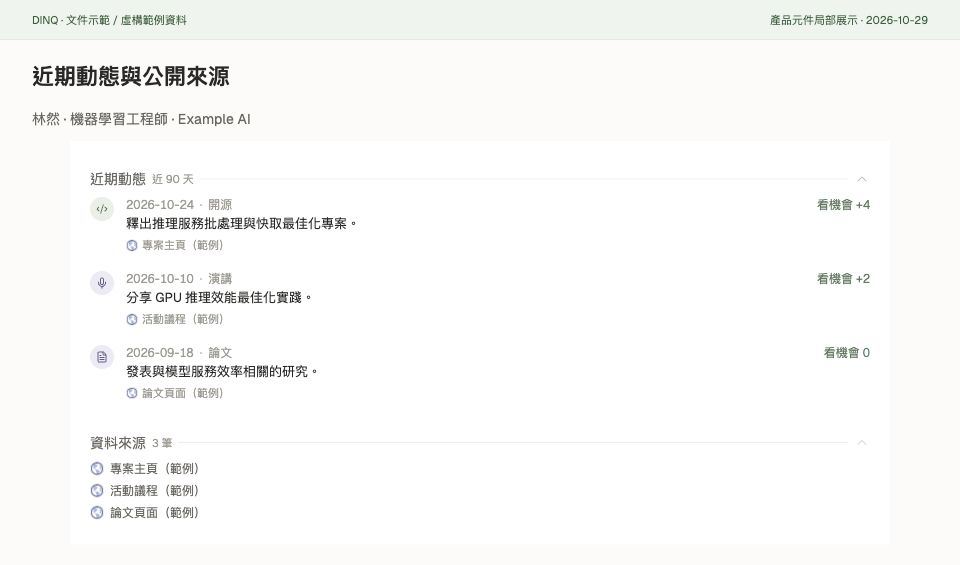
近期動態把可用的近 90 天公開事件整理為時間線,幫助你瞭解候選人最近在做什麼,也為核驗背景和準備有上下文的聯絡提供線索。常見型別包括論文、職位變動、開源、演講、新聞、社媒、榮譽和內容釋出。
每條動態按可用資訊展示:
- 日期與事件型別: 幫助判斷髮生時間和活動性質,不要把舊報道當成剛發生的事件。
- 事件摘要: 用簡短文字概括髮生了什麼,重要細節請回原始頁面核驗。
- 來源連結: 開啟論文、專案、機構公告、新聞或公開帖子,確認事件是否屬於同一個人。
- 對看機會指數的影響: 部分事件會顯示正負影響值,用於解釋模型判斷;它不是本人對外表達的求職意願,也不是該事件造成跳槽的證據。
例如,演示場景中一位候選人近期釋出了推理最佳化專案,你可以開啟倉庫檢查其實際貢獻,再圍繞相關工作準備溝通。單次演講、發帖或職位變化本身,不足以證明對方正在求職。
近期動態與千人千面的動態分析不是同一件事。 前者整理“最近發生了哪些公開事件”,後者說明“為什麼針對這個人、這次需求,採用這些指標和判斷”。近期動態可以成為分析依據,但不是每個事件都會改變分數。
時間線取決於生成時能夠獲取的公開記錄,並不是每次開啟都重新抓取。使用快取時,不要把它當作截至此刻的完整動態;沒有顯示記錄也不代表候選人沒有活動。持續發現人才可使用 人才雷達,重新產生規則見下文。
結合其他模組閱讀
- 匹配結果: 對當前需求的分數、結論、理由和關鍵詞。
- 教育與經歷: 可用的學校、機構、崗位和起止時間。
- 核心指標與代表作: 按人才型別選擇指標,並關聯論文、程式碼、專案或內容作品。
- 合作者或同事: 有公開依據的關係線索,不代表對方願意提供推薦。
- 職業階段與任期: 與 L1–L4 分開閱讀;在讀階段、任職年限和職責層次不是同一概念。
- 近期動態與來源: 可用的近 90 天公開事件、來源連結、生成時間和資料完整度。
看機會指數、崗位匹配分數、職業階段置信度和 L1–L4 分佈回答的是不同問題,不要把它們當成同一個評分,也不要用資料完整度代替能力判斷。
生成、快取與計費
搜尋頁新版檔案每次成功生成扣除 5 Credits。同一使用者在 7 天內,以相同姓名、匹配上下文、身份線索和語言請求,可複用已有檔案而不再扣費。
主動 重新產生檔案 會跳過快取,成功後再次扣費;切換語言或改變請求上下文也可能需要新生成。生成中的補充與精修是該次生成流程的一部分,不要把每條進度提示理解為又開了一次新的收費生成。
取得信箱是另外的操作,每位候選人成功取得信箱 20 Credits,不包含在檔案生成費用裡。完整規則見 定價與 Credits。
如何使用分析結果
先看候選人是否適合當前需求,再結合職級分佈理解工作範圍,最後用看機會指數和公開依據準備接觸方式。傳送前可在 觸達 中檢查收件人和草稿。
所有預測都應與事實欄位區分開。模型判斷不是本人意願、背景調查結論或錄用決定;未找到資訊也不等於不存在。重要判斷請回到原始來源,並通過作品評審、面試和本人確認核驗。